自然口语在生成语音之前就已经开始了。听众需要的是易于跟随的句子、熟悉的措辞,以及重要信息周围留出足够的空间。即使是高度富有表现力的声音,当它在朗读一段为静默快速浏览而写的段落时,仍可能听起来像是机械化的。
要把文字变成自然口语,请先准备口述版本、理顺发音、选择合适的声音,并测试一小段内容。针对你听到的具体问题进行修改,而不是用越来越“夸张”的指令去重新生成同一段文本。
下面的写作原则适用于各类工作流程,不过精确的控制项应来自你所使用的语音工具。
让文本在 XPT 中可口述
1. 告诉 XPT 由谁在聆听
打开 无限制AI写作神器 ,或使用一个 XPT 聊天,并提供这段内容。说明其目的、受众、语言以及预期的呈现方式。博物馆导览、内部说明和虚构独白需要不同的节奏。
明确哪些内容必须保持精确:姓名、日期、技术性表述、价格,或某一句特定对话。将已批准的来源放在附近。让一段内容听起来更顺畅不应改变其含义,也不能悄悄移除某个条件。
2. 请求“口述编辑”,而不是一篇新文章
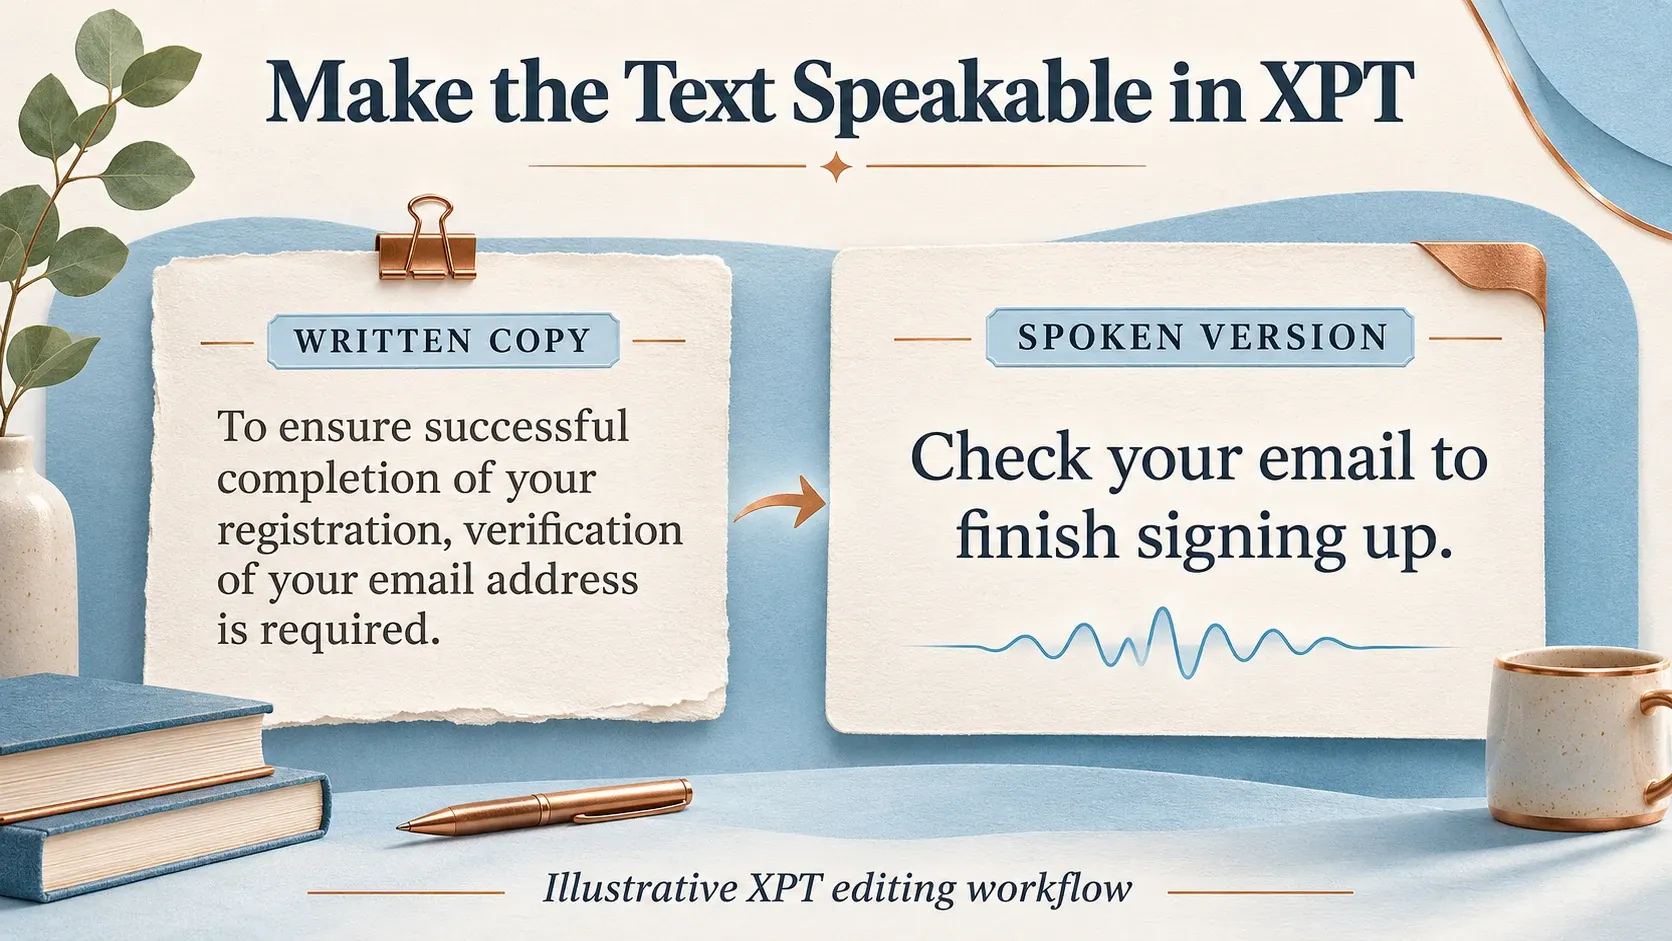
要求更短、更连贯的句子,并且一次只表达一个清晰想法。保留有用的衔接词,避免结果变成一串被截断的陈述。让 XPT 把“性能/呈现备注”放在要朗读的词语之外。
“编辑这段文字,使其适合冷静、对话式的配音。保留每一个事实细节和原定含义。减少读出来时听上去正式的长从句和长短语。让句子保持连贯。把发音疑问分开列出,不要添加新的引言。”
请你自己把修改后的版本大声读一遍。如果你读到某处卡住,先指出具体短语,而不是让模型把一切变得更自然。最好的修正可能只是调整一个从句位置,或替换一个含糊的代词,而不是改动整个段落。
3. 建立一份小型发音清单
识别姓名、缩写、日期、计量单位以及可能存在多种读法的词语。在生成之前先决定它们应该怎么读。若听众不先看到字母就无法理解缩写,请将缩写展开。
把这份清单与公开脚本分开。对语音工具有帮助的音标拼写,在转录稿里可能显得不对劲。在需要精确术语的情况下,请用可靠参考或懂得该名称的人来确认发音。
对于小说内容,可使用 AI故事大纲生成器 来整理反复出现的姓名以及需要的发声提示。请把这份参考明确保存起来,而不是假设某个聊天或语音工具会在跨会话时记住每一次选择。
4. 在可用的音频工作流中生成示例
检查你的 XPT 会话是否提供合适的语音输出选项。为本指南审阅的公开素材,并未建立专用的 XPT 文本转语音编辑器、语音目录或音频导出格式。如果这些不可用,请在兼容的语音工具中使用 XPT 的预备脚本,或采用人工录制的工作流。
选择一种日常表达就能匹配工作的声音。先从默认或较克制的设置开始,再去调整速度、情绪或其他控制项。声音与素材不匹配很难通过添加更多呈现提示来修复。
5. 把“可听到的瑕疵”再带回 XPT
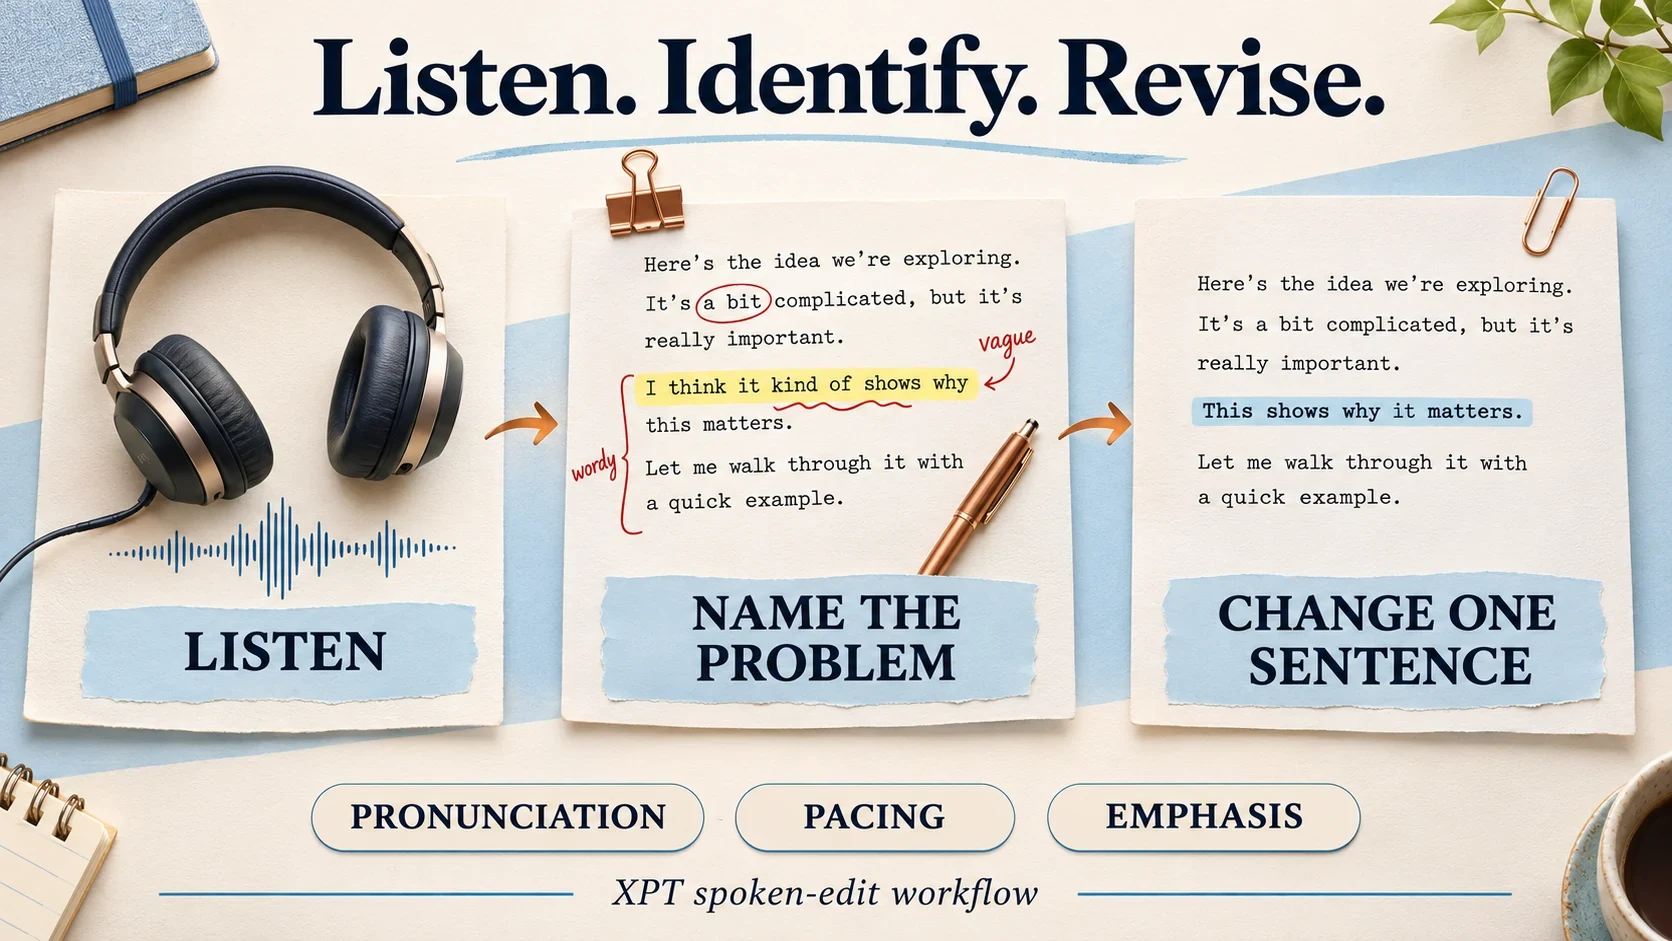
先不看脚本听一遍,再跟着脚本听一遍。记录一个精确问题:日期听起来含糊不清,第二句读得太急,或某个短语获得了错误的重音。然后让 XPT 对这一段做两次小幅改写,并确保信息保持不变。
“‘because’ 后面的短语听起来有点赶。请只用两种方式重写那一句话,保持相同的主张与限定。使用自然的口语节奏。不要改变其周围的段落内容。”
先用同样的声音与设置生成修订后的段落。这能让你对写作改动做出公平对比。只有在句子已经清晰之后,才再调整呈现方式。
在调整速度之前先修正节奏
长句可能需要一个完整停顿,但不是每个逗号都都需要戏剧性的停顿。留意“意义组”:那些放在一起就属于同一组的词语。打断这些组,即使每个词都读得正确,也会让句子听起来支离破碎。
如果清单中包含多个日期或步骤,请确保每一项都有足够的空间让人听懂。有时正确答案是两个简短部分,而不是更慢地朗读一整段信息密集的段落。先让结构来解决问题,再去拉长每一个词。
强调应当用来澄清要点
决定到底由哪个词承载含义。把“今天”和“明天”作对比的句子需要不同的重音;而把“估计值”和“保证”作对比的句子,其重音方式也不同。不要要求每一个听起来重要的词都同等强调。
情绪化指令要少用。中性的解释不必兴奋也能显得可信;而一个有反思特质的人也不需要把每一句都用耳语般的方式说出来。如果呈现指令一旦开始压过正文内容,就回到段落本身的意图。
避免从无关模型中复制停顿标签或发音语法。有些工具支持专门的控制项;另一些可能会把标记当作音频读出来,或直接忽略它们。在把某个提示应用到更长的脚本之前,先测试一个提示。
在最终语境中回顾这段话
在它将被播放的设备或项目里播放已保存的音频。检查首尾词、音量、停顿,以及与相邻段落之间的衔接。一个句子单独听起来很好,也可能在前一句之后立刻显得突兀。
自然口语是一串可理解选择的连续呈现。让文本更容易说,选择合适的声音,并根据你实际听到的效果去修改。