Ein Sprechfoto kombiniert ein Standbild-Porträt mit Sprache und generierter Mimik. Um es zu erstellen, brauchst du ein nutzbares Gesichtsbild, eine kurze gesprochene Nachricht oder eine Audiodatei sowie ein Tool, das das Porträt so animiert, dass es zur Sprache passt.
Das ist eine andere Aufgabe als, einem Landschaftsbild nur eine leichte Brise hinzuzufügen. Die Zuschauenden nehmen Aussprache, Mundtiming, Ausdruck und Identität gleichzeitig wahr. Ein polierter Hintergrund kann ein eingefrorenes Gesicht oder eine Stimme, die den falschen Namen ausspricht, nicht verstecken.
HeyGen’s Sprechgesichts-Seite beschreibt einen Workflow, der synchronisierte Lippen, Blinzeln und Kopfbewegungen zu einem Foto hinzufügt. Unterschiedliche Tools unterstützen unterschiedliche Eingaben. Prüfe daher, ob deins gesprochene Sprache als Text, eine aufgezeichnete Audiodatei oder beides akzeptiert, bevor du das finale Material vorbereitest.
Bereite ein Sprechfoto mit XPT vor
1. Wähle ein Porträt, das du verwenden darfst
Nutze dein eigenes Bild, ein autorisiertes Porträt oder eine originale fiktive Figur. Das Gesicht und der Mund sollten in dem geplanten Ausschnitt gut lesbar sein. Starke Verdeckungen, ein sehr starkes Seitenprofil oder ein zu kleines Gesicht in einer Gruppe machen das Ergebnis schwerer zu beurteilen.
Behalte die Quelle im Originalzustand. Wenn das Porträt eine kleine Anpassung braucht, bereite es mit dem AI Image Editor vor, bevor du die Sprechversion erstellst. Achte darauf, dass die Gesichtszüge nach jeder Aufbereitung weiterhin erkennbar bleiben.
Entscheide bei einer illustrierten Figur, ob das Tool, das du verwenden möchtest, für diese Art von Gesicht geeignet ist. Unterstützung für ein fotografisches Porträt bedeutet nicht automatisch gleichwertige Unterstützung für eine stark stilisierte Zeichnung oder eine Tierfigur.
2. Schreibe eine Nachricht, die sich gesprochen anhört
Gib XPT die Aufgabe, die Idee in einen prägnanten Satz mit einem klaren Zweck umzuwandeln. Gib der Zielgruppe, dem Ton, der Sprache und allen Namen, bei denen es Aussprachehinweise braucht, die nötigen Angaben. Halte Anweisungen getrennt von den Worten, die die Figur tatsächlich sagen soll.
„Schreibe eine kurze Begrüßung für einen fiktiven Museumsführer, der zum ersten Mal Besucher anspricht. Verwende warme, einfache Sprache und eine klare nächste Handlung. Halte es natürlich, wenn man es laut vorliest. Trenne Performance-Notizen so, dass sie nicht gesprochen werden.“
Lies den Satz selbst durch. Entferne eine lange Einleitung, eine wiederholte Begrüßung oder eine Liste, die nach Website-Text klingt. Ein Sprechfoto ist oft mit einem einzigen nützlichen Satz wirksamer als mit einer dichten Ankündigung.
3. Finalisiere das Audio, bevor das Gesicht animiert wird
Nutze eine unterstützte Text-to-Speech-Option oder zeichne die Zeile auf. Wenn XPT in deiner Sitzung eine passende Voice-Ausgabe bereitstellt, prüfe dort die verfügbaren Auswahlmöglichkeiten. Andernfalls verwende das in XPT vorbereitete Skript mit einem Voice-Tool oder mit deiner eigenen Aufnahme.
Hör zu, ohne auf das Bild zu schauen. Prüfe Namen, Daten, Zahlen, Pausen und das letzte Wort. Wenn das Audio falsch ist, korrigiere es jetzt. Eine spätere Änderung bei Sprechgeschwindigkeit oder Wortlaut kann einen weiteren Durchlauf der Gesichtsanimation erfordern.
Vermeide unnötige Anweisungen im gesprochenen Text. Tool-spezifische Delivery-Tags können unterschiedlich interpretiert oder vorgelesen werden. Nutze die dokumentierten Steuerelemente des Voice-Tools, statt anzunehmen, dass die Syntax eines Anbieters überall funktioniert.
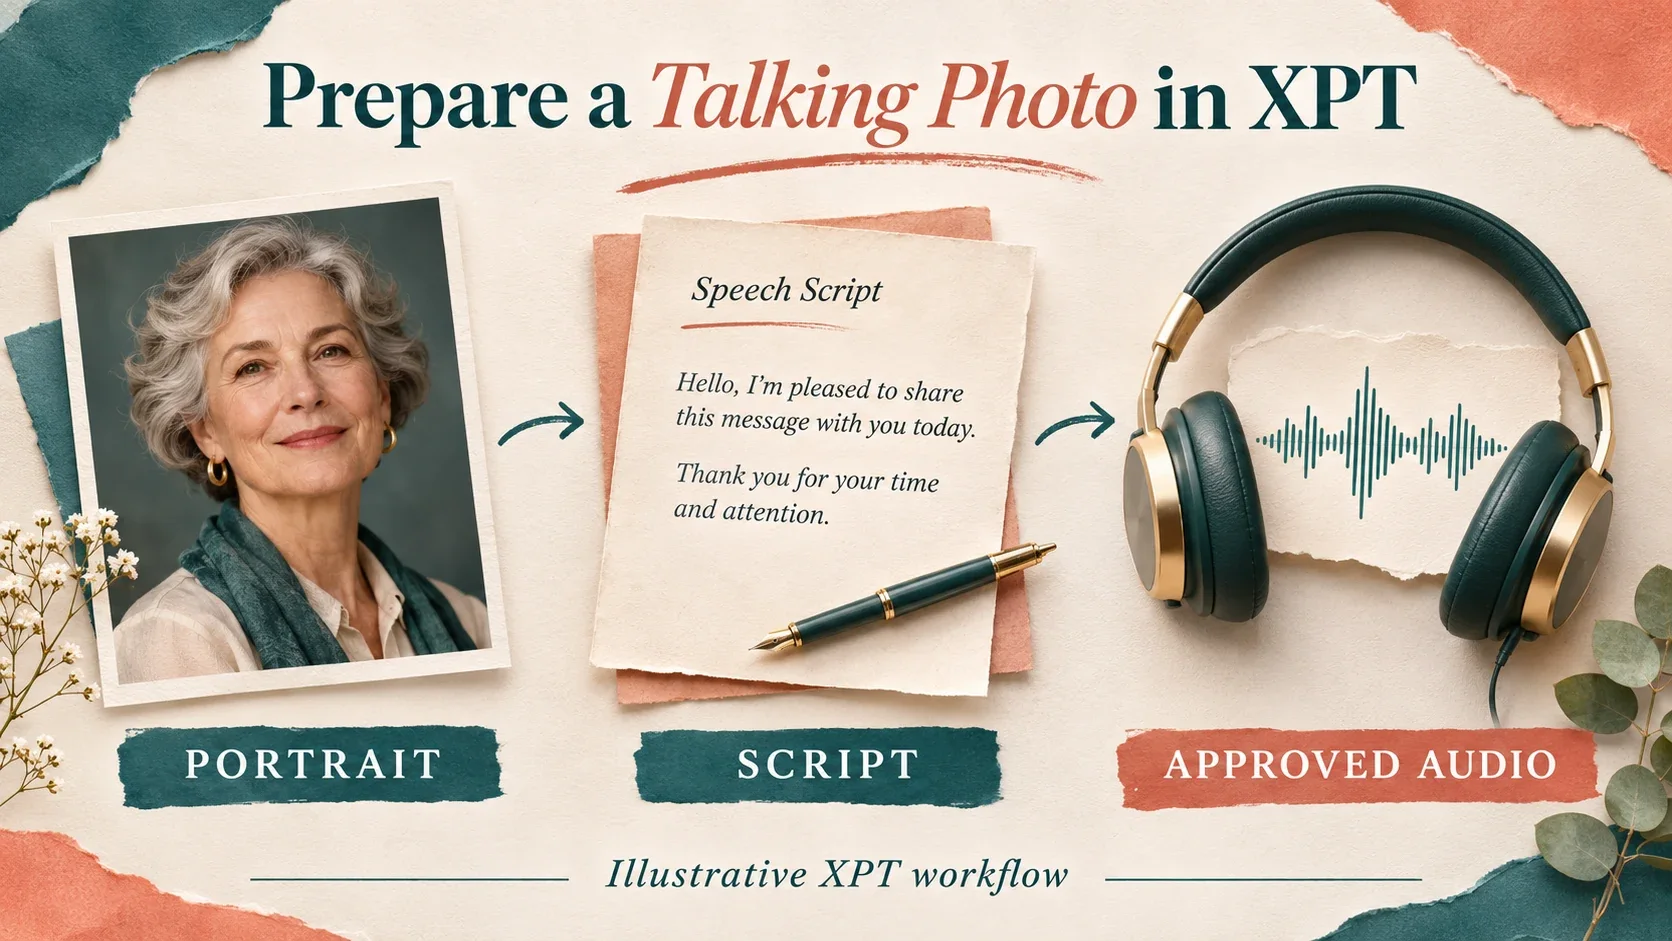
4. Kombiniere das Porträt mit genehmigter Sprache
Verwende einen kompatiblen Sprechfoto- oder Lip-Sync-Renderer. Die hier überprüften öffentlichen Seiten von XPT stellen keine dedizierte Sprechfoto-Oberfläche bereit. Prüfe daher deine tatsächliche Sitzung, bevor du davon ausgehst, dass direkt Videoausgabe verfügbar ist. Wenn nicht, bleibt XPT trotzdem nützlich für das Skript und die Performance-Short-Description.
„Verwende dieses autorisierte Porträt mit dem genehmigten Audio. Halte Gesicht, Frisur, Zuschnitt und Hintergrund stabil. Nutze einen ruhigen Ausdruck und zurückhaltende Kopfbewegungen. Gleiche die sichtbare Sprache mit dem Audio ab und bewahre die Pausen. Füge keine Wörter hinzu.“
Die Seite zum AI Lip Sync Generator strukturiert dieses audiozentrierte Produktionsbriefing. Das Rendern hängt davon ab, welchen kompatiblen Workflow du auswählst.
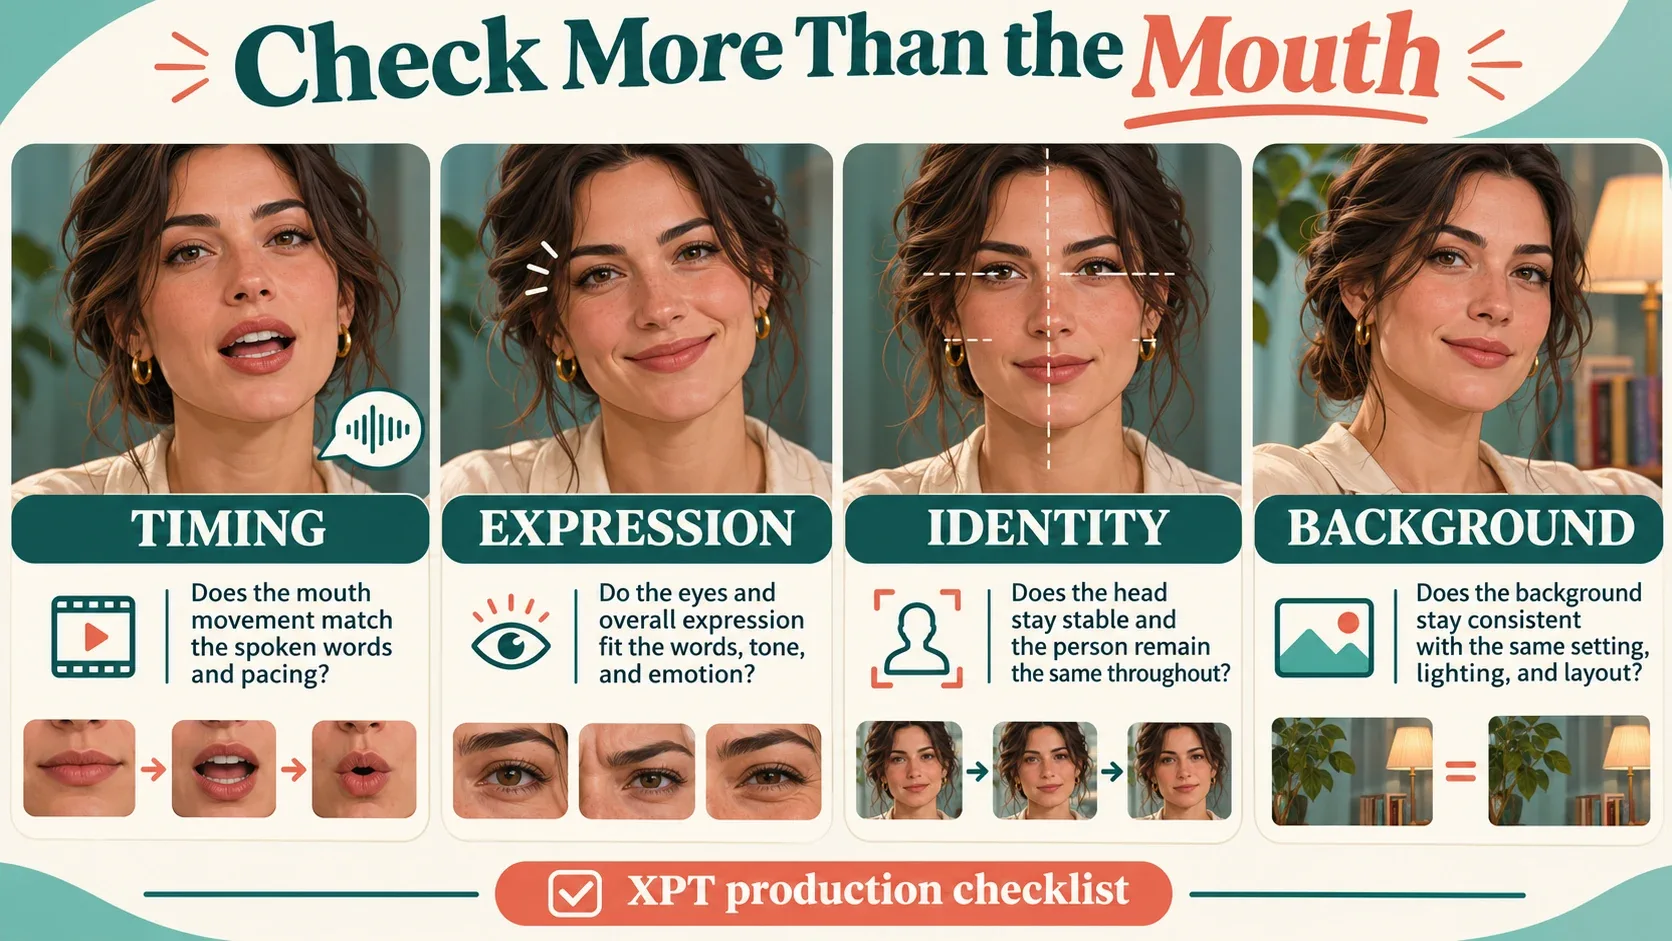
5. Prüfe die Person genauso wie den Mund
Schau bei normaler Geschwindigkeit mit Ton. Achte auf Sprache, die beginnt, bevor sich die Lippen bewegen, auf einen Mund, der auch in der Stille weiter bewegt wird, oder auf einen Ausdruck, der nicht zur Zeile passt. Untersuche dann schwierige Momente genauer.
Prüfe Augen, Zähne, Wangen, Kiefer und Haaransatz. Ein Mund kann aktiv wirken, während der Rest des Gesichts eingefroren aussieht. Achte außerdem darauf, dass der Hintergrund nicht pulsiert oder sich verändert, wenn der Kopf sich bewegt.
Bessere Sprache beginnt mit einem kleineren Skript
Wenn sich eine Zeile gehetzt anfühlt, kürze sie, bevor du die Geschwindigkeit anpasst. Wichtige Namen oder Anweisungen brauchen Platz, um verstanden zu werden. Lies Zahlen so, wie du möchtest, dass die Zuhörenden sie hören, und gib unbekannten Begriffen einen Aussprachehinweis außerhalb des gesprochenen Textes.
Für die Lokalisierung übersetze Bedeutung und Darbietung, statt jedes Wort mechanisch nachzubilden. Der neue Satz kann länger sein als der ursprüngliche. Genehmige das übersetzte Audio, bevor du das Gesicht es ausführen lässt.
Der Leitfaden zum Generieren einer KI-Stimme aus Text behandelt diese Audio-Vorbereitungsphase ausführlicher. Halte die Freigabe der Stimme getrennt von der visuellen Freigabe, damit du weißt, welche Eingabe Aufmerksamkeit braucht.
Häufige Probleme und die nächste sinnvolle Lösung
Wenn sich das Gesicht zu stark verändert, reduziere die Kopfbewegung und gehe zur Ausgangsaufnahme zurück. Wenn der Mund schlecht synchron wirkt, bestätige, dass die finale Audiodatei diejenige ist, die tatsächlich verwendet wurde. Wenn die Darbietung unnatürlich ist, schreibe die Sprache neu oder generiere sie erneut, bevor du das Bild änderst.
Wenn eine Geste oder eine Kopfwendung für die Botschaft entscheidend ist, ziehe ein vorhandenes Video oder einen anderen Produktionsansatz in Betracht. Ein einzelnes Standbild zeigt nicht alle Blickwinkel des Gesichts, und generierte Bewegungen können Details hinzufügen, die die Quelle nicht verifizieren kann.
Prüfe den tatsächlich gespeicherten Clip auf dem Bildschirm, auf dem Menschen ihn anschauen werden. Kleine Gesichtsartefakte fallen in einem großen Player oft stärker auf, während ruhige Konsonanten über einen Lautsprecher am Telefon verschwinden können. Bewerte Ton und Bild in diesem Kontext, bevor du das Ergebnis freigibst.
Halte das Porträt, das genehmigte Skript, das Audio und die ausgewählte Ausgabe zusammen. Wenn du eine kreative Animation einer echten Person teilst, gib genug Kontext, damit Zuschauende es nicht für eine authentische Aufnahme oder eine Bestätigung halten.
Mach die Botschaft zuerst nützlich, dann mache ihre Darbietung stimmig. Ein erfolgreiches Sprechfoto gibt dem Gesicht eine klare Zeile, eine passende Umsetzung und genug Zurückhaltung, damit die Zuschauenden sich auf das konzentrieren können, was gesagt wird.