テキストからAI音声を生成するには、実際に話す正確な文言を用意し、テキスト読み上げ(TTS)の音声を選び、短いサンプルを生成してから、全文を作成する前に必ず聞いて確認します。結果の品質は、音声そのものと、指定した内容を音声として再現するための文章の両方に左右されます。
黙読して読みやすい1文は、声に出すと詰まって聞こえることがあります。省略語、日付、ブランド名、長い節(節のかたまり)は、よく問題が起きるポイントです。文章を直すことは、感情指示を変えながら同じ段落を何度も生成するよりも効果的な場合がよくあります。
これらの詳細はツール固有です。別のサービスでは、タグ、ポーズ指示、または表記(発音表記)の挙動が同じとは限りません。
XPTで音声を準備してから、音声を生成する
1. スクリプトに明確な「聞く状況」を与える
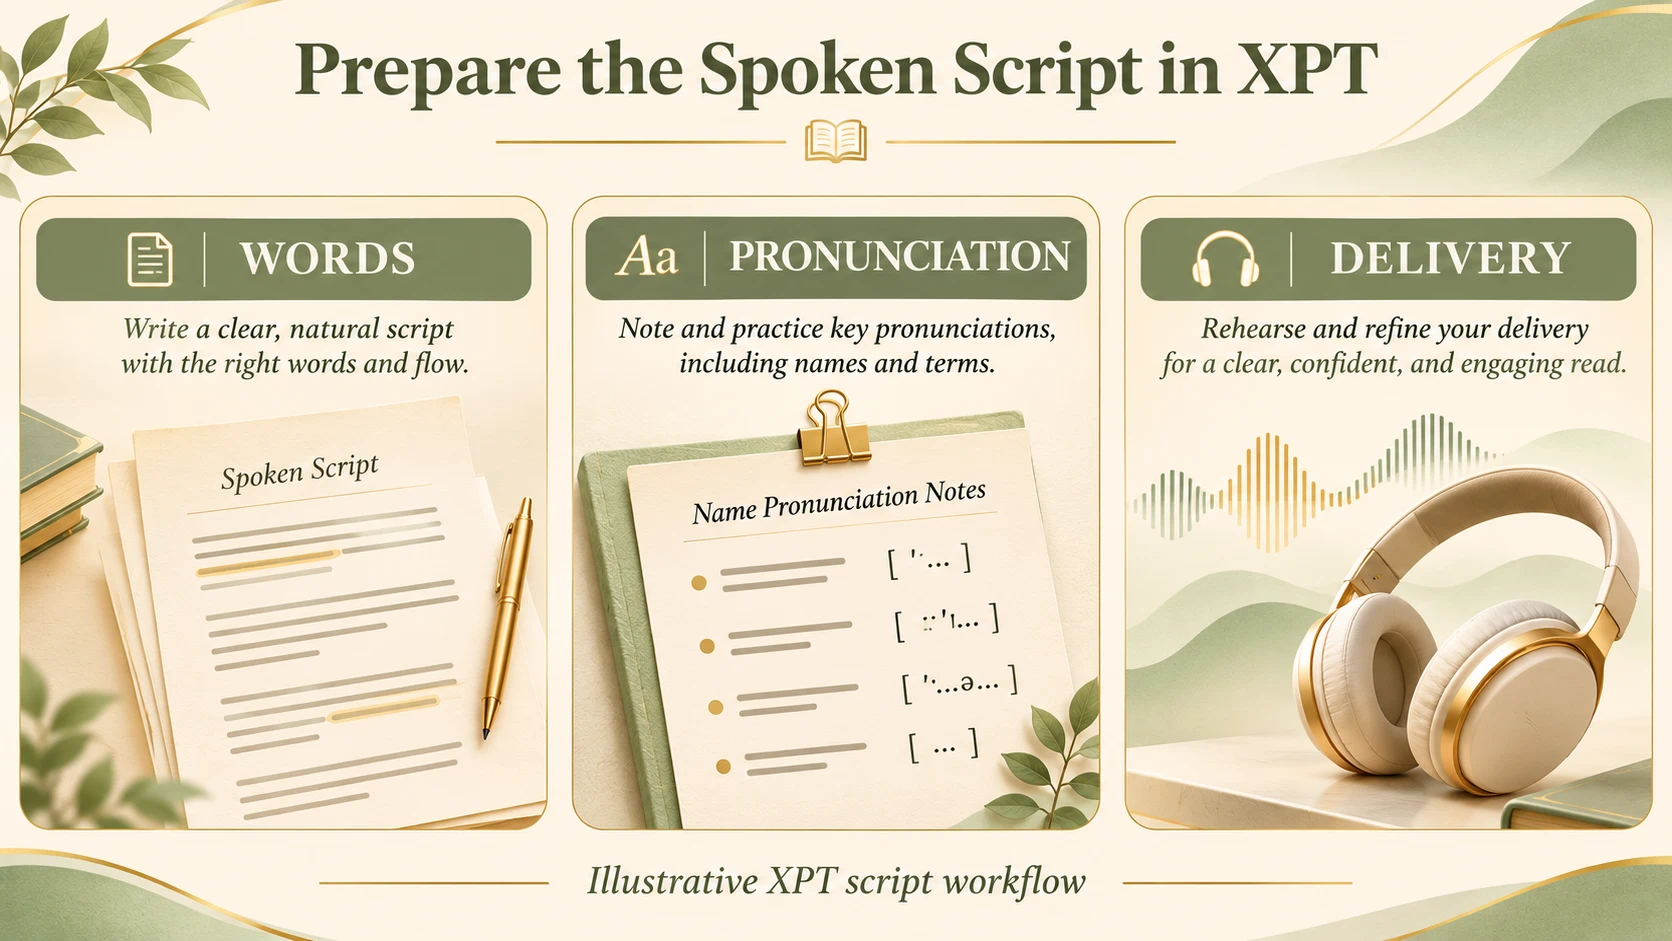
音声が何のためかをXPTに伝えます。短いイントロ、説明用のナレーション、キャラクターのセリフ、あるいは長めの物語パッセージなどです。対象の聴衆と使用言語を指定し、トーンは「落ち着いた」「会話調」などの通常の言葉で示してください。相反する方向性を積み重ねるよりも、はっきりした意図の方が伝わります。
Unfiltered AI Writer を使って、話す用途に合わせて書かれた文章を組み替えます。意味を保ちながら、詰まりやすい文を短くし、制作メモ(生成用の注記)と読み上げるべき文言を分けるよう依頼してください。読み上げられてしまっても問題ない内容以外の指示を、スクリプト内に入れないでください。
2. 名前、数字、発音を解決する
生成の前に、短い発音リストを作成します。馴染みのない名前、省略語、日付、計測値、複数の読み方があり得る単語を含めてください。あいまいさが減る場合は数字を話し言葉の形で書き、まず意図する意味を確認します。
“この告知を自然な音声向けに書き換えてください。すべての事実と、呼びかけ(コール・トゥ・アクション)を維持してください。短く、つながりのある文にしてください。聞き手が理解できない略語は、わかる形に展開してください。発音の質問や配信(デリバリー)の注意点は、スクリプトの中ではなく、後ろに配置してください。”
出力結果を元の文章と照合します。読み上げ向けに書き換えても、日付、価格、条件、人物名は変わるべきではありません。より滑らかだからといって、誤った情報を伝えてしまっていれば改善とは言えません。
3. 実際の音声生成ワークフローを選ぶ
XPTセッションに、適切な音声出力オプションがあるか確認します。この文章のために確認した公開XPT素材だけでは、特定のテキスト読み上げインターフェース、音声フォーマット、ボイスカタログ、またはエクスポート可否は確立されていません。利用できない場合は、準備したスクリプトを互換性のある音声ツールで使うか、自分で録音してください。
魅力的なデモだけでなく、言語に対するデフォルトの出力と適性で音声を選びましょう。控えめな説明調、活気のある広告、親密なフィクションの独白では、求められる表現が変わります。
実在の人物のように聞こえる音声を目指すなら、適切な許可を取得し、その用途に対応したワークフローを使用してください。通常のテキスト読み上げでは人のクローンは不要であり、汎用ボイスを「本人の真正な録音」として提示すべきではありません。
4. 短い診断用サンプルを生成する
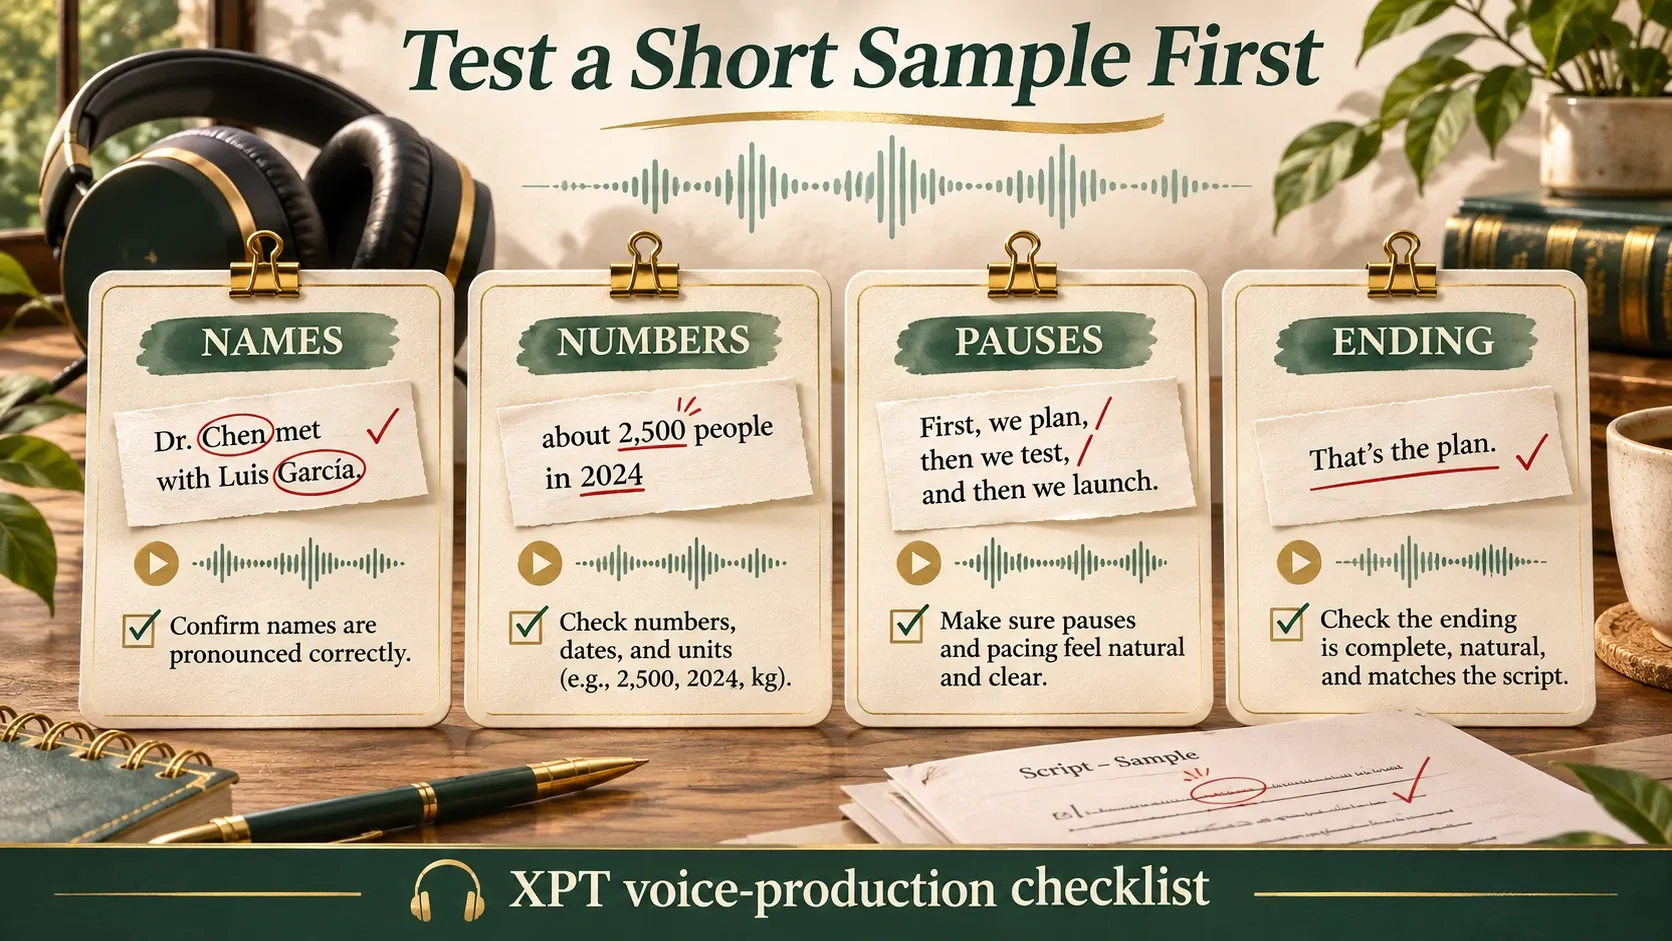
難しい名前、ポーズ、意図したトーンが入っている箇所から始めます。単なる「こんにちは」は、全文スクリプトがうまく機能するかどうかを判断するには情報が少なすぎます。選んだ音声モデルのためにドキュメント化されたコントロールを使い、比較できる程度に変更を小さく保ってください。
一度、字幕のように読み上げを追わずに聞いてみましょう。メッセージは即座に理解できますか?理解できたら、文字起こしに沿って、聞き落とされた単語、数字の誤り、変な強勢(アクセント)、不自然な終わり方がないか確認します。音楽や動画編集に取りかかる前に、発音を先にチェックしてください。
5. 残りのセクションを生成し、つなぎ目をまたいで聞く
サンプルが問題なく動くことが確認できたら、扱いやすい単位に分けて生成します。連続性が重要な場合は、承認済みの同じ音声と関連設定を維持しましょう。長尺の作業では、各パッセージ内だけでなく、セクション境界でもチェックが必要です。
テンポ、音量、感情、録音のキャラクターに突然の変化がないかを聞きます。ある1文は単体だと良く聞こえても、直前の文の横に置くと唐突に感じることがあります。承認された文言とデリバリーに戻せるよう、バージョン記録を残してください。
意味が伝わるように句読点を書く
句読点は、パフォーマンスの小技の集まりとしてではなく、文の意味を支えるために使います。ピリオッド(終止符)は、完結した考えを示す位置に置くべきです。コンマ(読点)は文章の構造を助けますが、数語ごとに追加すると、読み上げが途切れ途切れになって聞こえることがあります。
その行が、理解するために不自然にたくさんのポーズの合図を必要とするなら、書き換えてみてください。長い文を分割したり、挿入句(カッコ書きの注記)を移動したり、リストを減らしたりします。選んだモデルがそれをサポートしているか確認した後でのみ、モデル固有のタグを使ってください。
役立つ場合は、2つのバージョンを用意します。承認済みの書き言葉の原稿と、略語を展開したり発音の補助を加えたりして読み上げに適した版です。これにより事実確認がしやすくなり、発音の綴りをそのまま「書かれたテキスト」として誤って公開してしまうのも避けられます。
音声を目的地に合わせる
動画のナレーションでは、顔の同期や、映像をナレーションに合わせて厳密にカットする前にタイミングを承認してください。AIで会話する“トーキング写真”を作る方法 のガイドでは、最終オーディオは口元のアニメーションより先に用意すべき理由を説明しています。
フィクションの場合は、ドラマチックなデリバリーを加える前に話者を定義します。AIキャラクター説明ジェネレーター が、動機、話し方の癖、話すスタイルを固めるのに役立ちます。そうした判断を使って、毎文で最大限の感情を求めるのではなく、セリフを導くようにします。
長いナレーションでは、すべての章を準備する前に代表的な段落をテストしてください。時間が経っても音声が理解しやすいままであるか確認し、シーンやセクションの区切りといった論理的なタイミングで見直し計画を立てます。強い短いデモだけでは、原稿全体での一貫性は保証できません。
保存したファイルと利用条件を確認する
保存したオーディオを、実際に使用するアプリケーションで再生します。冒頭と最後の単語が入っているか、音量が適切か、ファイルが想定どおりに動作するかを確認してください。プレビューが最終成果物であると決めつけず、フォーマットやデリバリー要件は実際のツールで確認します。
あわせて、プランの利用権も確認しましょう。選んだサービスの現在の利用条件を適用してください。サンプルを生成しただけで、自動的に公開権が確定するわけではありません。
承認済みのスクリプト、発音メモ、設定、選択した音声はまとめて管理します。信頼できる音声ワークフローは、「聞き手が追える言葉」から始まり、実際にチェックした保存録音で終わります。