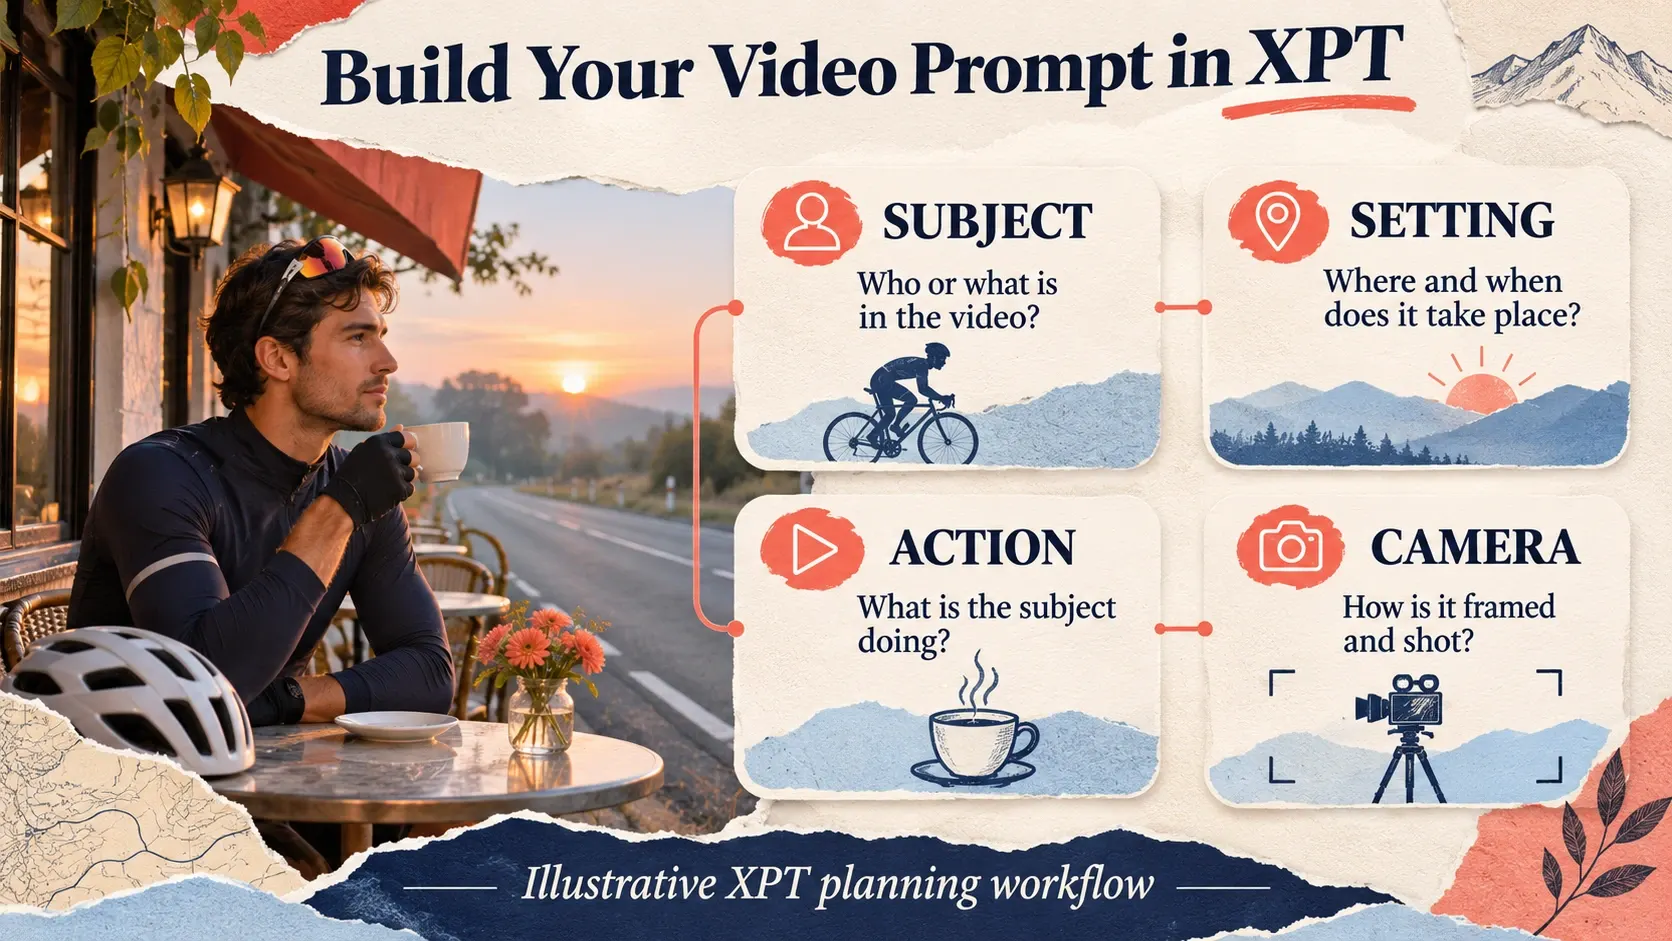
从文本生成视频,首先要有一段你能清楚描述的镜头:一个主体、一个场景、一个动作,以及一个相机选择。诸如“城市醒来”这样的故事前提,能够启发多个画面,但它还不能告诉视频模型在一段连续镜头中究竟要发生什么。
从最小且有用的镜头开始。只要这个镜头可行,你就能再规划另一个镜头,并将它们组装成一段序列。更广泛的原则是:把生成视为“镜头的创作”,而不是从一小段文字就凭空“生成出一部完整电影”。
XPT 可以帮助你把一个想法变成那份制作简报。之后的渲染则取决于你在当前会话中可用、或你所选工作流中兼容的视频工具。
在 XPT 中构建视频提示词
1. 描述该镜头必须完成的工作
先从受众以及预期位置开始。它是开场画面、用于解释的插入镜头、产品氛围研究,还是场景之间的过渡?答案能帮助你判断该把哪些内容放在重点。
使用 AI文生视频 的简报结构,向 XPT 提供主体、地点、视觉处理方式以及期望动作。加入一些有用的限制,例如如果不需要精确的字母内容,就让招牌文字保持在画面之外。
避免在单个镜头里要求完成一段完整冒险。如果这个想法包含出发、旅程和抵达,先让 XPT 把它拆成三个节拍,然后先选择其中一个来开发,再生成任何内容。
2. 要求一个连续镜头
把抽象的氛围变成可见的选择。孤独是一种感受;一个人在空旷的路旁等待,就能让镜头知道该展示什么。戏剧感很宽泛;低机位视角和刻意的光线方向,都是你可以检视的具体决定。
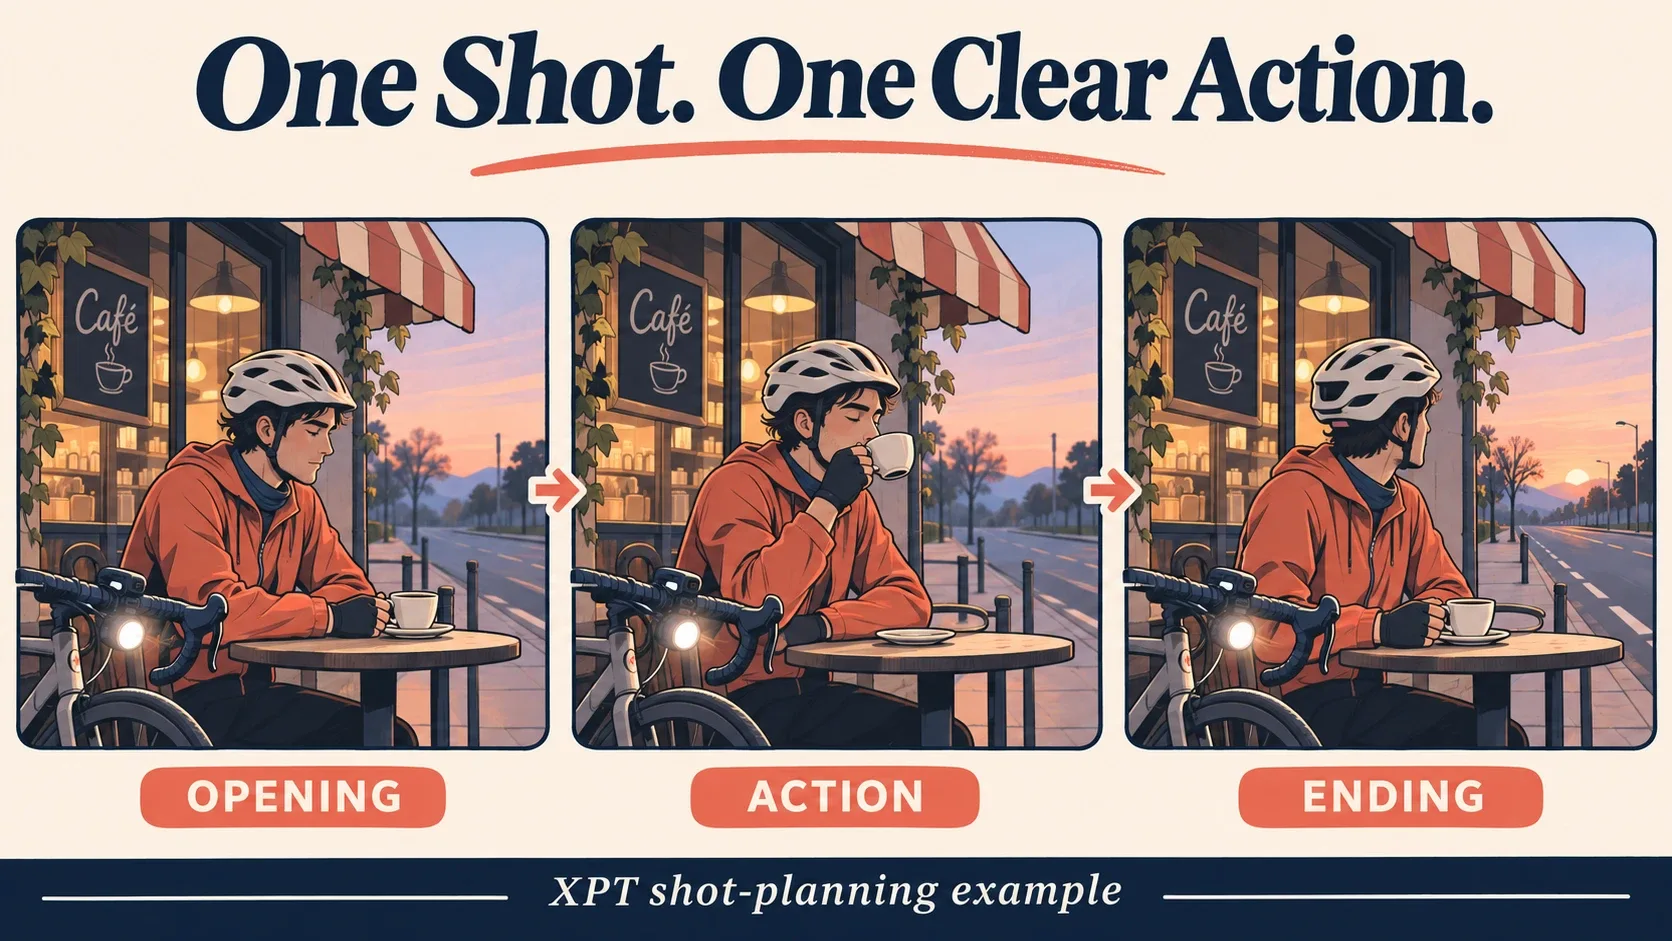
“为一个安静的开场镜头写一条连续的视频提示词。黎明时,一位骑行者站在路边咖啡馆旁,举起一只纸杯,然后望向空荡的公路。使用中宽幅构图,并保持克制的向前镜头推移。让氛围保持平静。不要添加字幕或场景切换。”
这个提示词包含开头、可见动作以及相机选择。不需要渲染器去编造剪辑段落或复杂的事件链条。
3. 解决相互矛盾的指令
在渲染之前,先让 XPT 识别冲突。固定不动的相机不可能同时环绕主体。特写也许无法展示全身动作。要求产品标签保持精确,可能无法很好地匹配快速旋转。
决定哪一项要求最重要。把替代版本分开保留:一个静态镜头、一个慢推镜头、一个更广角的镜头。如果你在第一条请求里把三者都合并,生成出来的片段会更难评估。
4. 在可用的视频工作流中生成
检查你的 XPT 会话是否提供兼容的渲染选项。针对本指南审核的公开 XPT 材料,并未建立特定的视频模型、剪辑时长控制或导出权限。如果会话不支持渲染视频,就把已获批准的提示词复制到你能访问的文本转视频工具中。
确认那里的模型、裁剪、时长、成本以及输出设置。文本转视频与图像转视频即使在同一个服务中,也可能有不同的控制项。把精确的界面操作说明与您实际使用的工具绑定。
5. 把可见的不匹配找回来
先观看完整片段,再与简报逐项对照:主体有没有执行该动作?镜头移动是否如预期?物体是否发生变化或消失?在目标保存尺寸下检查导出的结果。
一个有用的后续步骤是找出失败之处:骑行者开始走路了,相机朝侧面转动了,或纸杯的形状变了。让 XPT 在保持已批准选择的同时,简化那一部分提示词内容。如果反复修改导致失去该镜头的目的,就回到原始简报。
可复用的镜头模板
“[shot size] 视角的 [subject],置于 [setting]。主体 [one visible action]。相机 [one movement or remains fixed]。使用 [lighting and visual treatment]。保持 [important continuity details]。单个连续镜头。”
把方括号替换为会改变画面的信息。避免重复那些无法告诉渲染器“应该展示什么”的质量词。想了解更多如何把你希望的改变从受保护细节中拆分出来,请参阅 AI图片编辑提示词。
不要把模板当作必须遵守的语法。有些模型对简洁的自然语言散文反应更好,而不是对长长的列表。根据所选工具的官方指导对模板做适配,并对照结果,而不是假设所有提示词行为都通用。
当参考图像是更好的起点
文本会留下很多外观选择空间。如果你已经批准了某个角色、产品或构图,那么就用一张静态图作为视觉锚点。在你编写运动(motion)部分之前,AI图片编辑 可以帮助你准备该素材来源。
参考图并不等同于保证精确保留。请在最终片段中检查面部、服装、标志以及几何结构。如果某个元素必须保持完全一致,考虑把它保留在单独的编辑图层中,或用更传统的方式把它拍摄出来。
当探索是目标时,使用仅文本生成。当连续性是核心要求时,使用已批准的视觉素材。在这两种路线之间做选择,往往比让同一条文本提示词变得更长更有帮助。
在镜头之后再构建编辑
把标题、字幕、旁白、音乐与镜头顺序作为彼此独立的决策来保留。渲染器可能会提供其中一些,但可用性会因情况而不同,且准确措辞仍需要预先检验。不要要求生成的背景招牌去承载关键信息。
保存每个镜头的源提示词,并记录已批准的动作、相机设置以及视觉锚点。当多个片段共享同一个角色或地点时,在把它们当作一个序列之前,先把它们放在一起进行对比。
一个实用的文本转视频工作流,能把一个模糊的想法变成可见的具体决策,然后再把这些决策用到实际输出中进行测试。写清楚一个镜头,从结果中学习,再用同样的谨慎去构建下一个镜头。