Um eine KI-Stimme aus Text zu erzeugen, bereite die exakt gesprochenen Wörter vor, wähle eine Text-to-Speech-Stimme, erstelle ein kurzes Beispiel und höre es dir an, bevor du den vollständigen Abschnitt produzierst. Die Qualität des Ergebnisses hängt sowohl von der Stimme als auch von dem Schreiben ab, das die KI ausführen soll.
Ein Satz, der sich beim stillen Lesen gut anfühlt, kann laut ausgesprochen schnell überfüllt wirken. Abkürzungen, Daten, Markennamen und lange Satzkonstruktionen sind typische Problemstellen. Das Korrigieren des Textes hilft oft mehr als das wiederholte Erzeugen desselben Absatzes mit unterschiedlichen Anweisungen zu Emotionen.
Diese Details sind toolspezifisch: Gehe nicht davon aus, dass ein Tag, eine Pausen-Anweisung oder eine phonetische Notation in einem anderen Dienst identisch funktioniert.
Bereite die Stimme in XPT vor und generiere dann das Audio
1. Gib dem Skript einen klaren Hörkontext
Erkläre XPT, wofür der Audio-Content gedacht ist: eine kurze Einführung, ein erklärender Voiceover, eine Dialogzeile oder eine längere erzählerische Passage. Nenne Zielgruppe und Sprache. Formuliere den gewünschten Ton in ganz normalen Worten, etwa ruhig und gesprächig, statt unvereinbare Richtungen zu stapeln.
Nutze den Unfiltered AI Writer, um geschriebene Texte für die Sprache umzugestalten. Bitte ihn, die Bedeutung zu erhalten, überfüllte Sätze zu verkürzen und Produktionsnotizen von den gesprochenen Wörtern zu trennen. Füge keine Anweisung in das Skript ein, außer du bist damit einverstanden, dass sie laut vorgelesen wird.
2. Kläre Namen, Zahlen und Aussprache
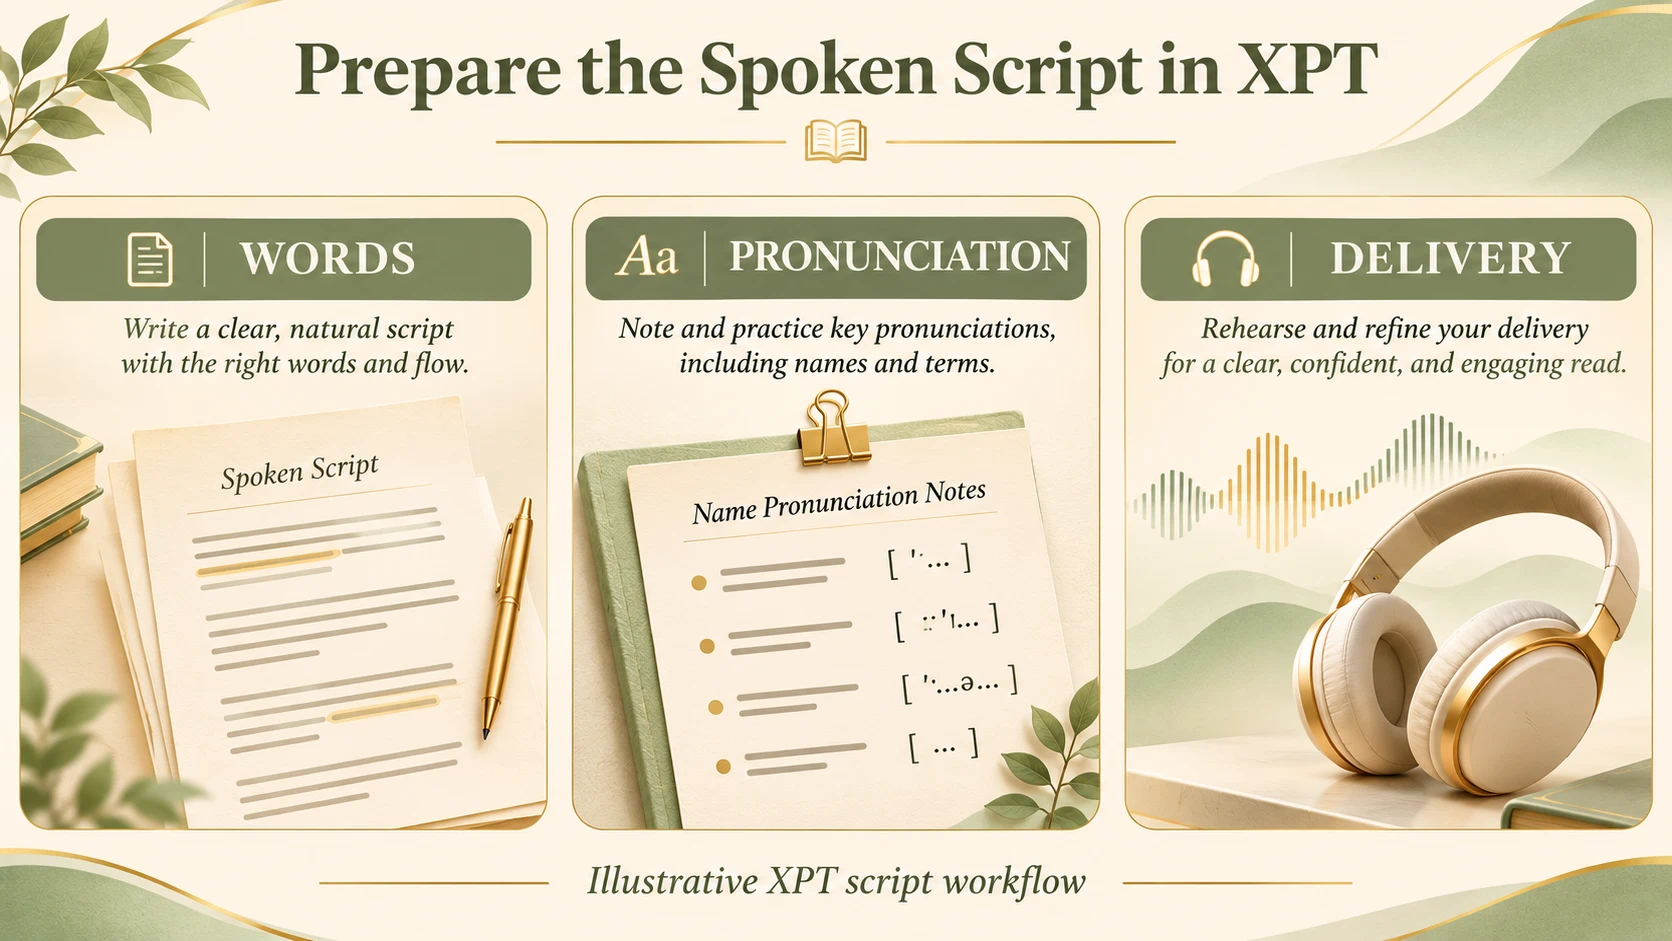
Erstelle vor der Generierung eine kurze Ausspracheliste. Füge ungewohnte Namen, Abkürzungen, Daten, Maßeinheiten und Wörter hinzu, die mehr als eine Lesart haben. Schreibe Zahlen in gesprochener Form, wenn das die Mehrdeutigkeit entfernt, und bestätige zunächst die beabsichtigte Bedeutung.
„Formuliere diese Ankündigung für eine natürliche Sprache um. Behalte alle Fakten und den Call to Action bei. Verwende kurze, verbundene Sätze. Erweitere Abkürzungen, die ein Zuhörer nicht versteht. Stelle Aussprachefragen und Hinweise zur Darbietung nach das Skript, nicht in das Skript hinein.“
Prüfe das Ergebnis gegen die Vorlage. Beim Umschreiben für Sprache sollte sich weder ein Datum, ein Preis, ein Zustand noch der Name einer Person ändern. Eine flüssigere Zeile ist keine Verbesserung, wenn sie die falschen Informationen vermittelt.
3. Wähle den konkreten Workflow zur Stimmerzeugung
Prüfe, ob deine XPT-Session eine geeignete Option für die Stanzausgabe bietet. Öffentliche XPT-Materialien, die für diesen Artikel geprüft wurden, belegen keine spezifische Text-to-Speech-Schnittstelle, kein Audioformat, kein Voice-Katalog und keine Exportberechtigung. Falls es nicht verfügbar ist, nutze das vorbereitete Skript in einem kompatiblen Voice-Tool oder zeichne es selbst auf.
Wähle eine Stimme anhand ihrer standardmäßigen Auslieferung und ihrer Eignung für die Sprache – nicht nur anhand einer attraktiven Demo. Eine zurückhaltende Erklärung, eine lebendige Werbung und ein intimer fiktiver Monolog verlangen jeweils unterschiedliche Performances.
Für eine erkennbar echte Personenstimme hole dir eine passende Genehmigung ein und nutze einen Workflow, der diese Nutzung unterstützt. Normales Text-to-Speech erfordert kein Cloning einer Person, und eine generische Stimme sollte nicht als authentische Aufnahme von jemandem präsentiert werden.
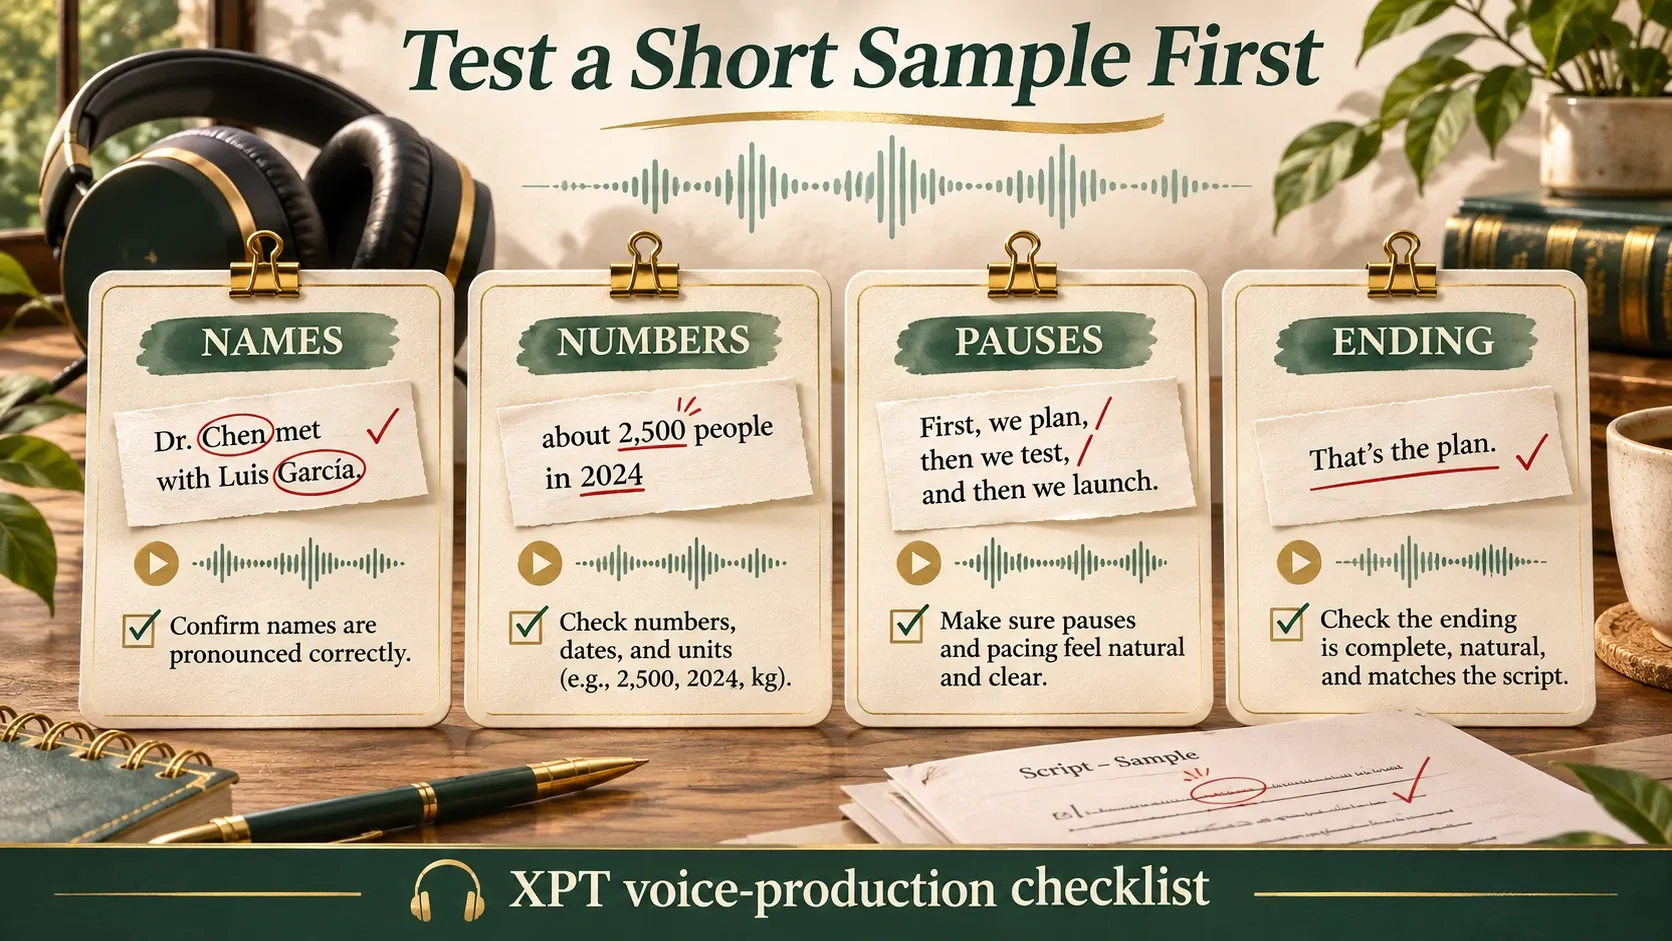
4. Erzeuge eine kurze diagnostische Probe
Beginne mit dem Abschnitt, der den schwierigen Namen, eine Pause und den beabsichtigten Ton enthält. Ein generisches Hallo sagt dir wenig darüber, ob das vollständige Skript funktionieren wird. Nutze die für das gewählte Voice-Modell dokumentierten Steuerungen und halte Änderungen so klein, dass sie sich gut vergleichen lassen.
Höre einmal zu, ohne mitzulesen. Verstehst du die Botschaft sofort? Folge dann dem Transkript, um verpasste Wörter, Zahlenfehler, ungewöhnliche Betonungen oder ein unnatürliches Ende zu erkennen. Prüfe die Aussprache, bevor du Zeit für Musik oder einen Video-Edit aufwendest.
5. Erzeuge die restlichen Abschnitte und höre über Übergänge hinweg
Sobald die Probe funktioniert, generiere überschaubare Abschnitte. Behalte dieselbe genehmigte Stimme und die relevanten Einstellungen bei, wenn Kontinuität wichtig ist. Bei längeren Arbeiten sind Checks auch über die Grenzen einzelner Abschnitte hinweg nötig – nicht nur innerhalb einzelner Passagen.
Achte auf plötzliche Änderungen bei Tempo, Lautstärke, Emotion oder „Aufnahmecharakter“. Ein Satz kann für sich genommen gut klingen und sich daneben trotzdem abrupt anfühlen. Führe eine Versionshistorie, damit du zu den akzeptierten Formulierungen und der Darbietung zurückkehren kannst.
Setze die Interpunktion für eine aussagekräftige Sprache
Nutze Satzzeichen, um den Satz zu stützen – nicht als Sammlung von Performance-Tricks. Ein Punkt sollte einen abgeschlossenen Gedanken markieren. Kommas können helfen, eine Zeile zu strukturieren, aber ein Komma nach fast jedem paar Wörtern kann die Darbietung holprig machen.
Wenn die Zeile viele künstliche Pausenhinweise braucht, um verständlich zu sein, versuche eine Neufassung. Teile einen langen Satz, verschiebe einen Einschub oder reduziere eine Liste. Nutze nur model-spezifische Tags, nachdem du geprüft hast, dass das gewählte Modell sie unterstützt.
Halte zwei Versionen bereit, wenn es hilfreich ist: die genehmigte geschriebene Fassung und eine Sprech-fähige Version mit erweiterten Abkürzungen oder Aussprachehilfen. So wird die sachliche Prüfung einfacher und du vermeidest, dass phonetische Schreibweisen versehentlich als geschriebener Text veröffentlicht werden.
Ordne das Audio seinem Ziel zu
Bei einem Video-Voiceover solltest du die Timing-Freigabe geben, bevor du ein Gesicht synchronisierst oder die Bildsequenzen eng um die Erzählung schneidest. Der Guide zu KI Talking Photos erstellen erklärt, warum das finale Audio vor der Mundanimation kommen sollte.
Für Fiktion: Definiere die sprechende Person, bevor du die dramatische Darbietung hinzufügst. Der AI Character Description Generator kann dabei helfen, Motivation, Auftreten und Sprechstil festzulegen. Nutze diese Entscheidungen, um die Zeile zu steuern – statt in jedem Satz maximale Emotion anzufordern.
Bei längeren Erzählungen teste eine repräsentative Passage, bevor du jedes Kapitel vorbereitest. Prüfe, ob die Stimme über die Zeit hinweg verständlich bleibt, und plane das Review an sinnvollen Stellen wie Szenen- oder Abschnittswechseln. Eine starke kurze Demo beweist noch keine Konsistenz für ein ganzes Manuskript.
Prüfe die gespeicherte Datei und die Nutzungsbedingungen
Spiele das gespeicherte Audio in der Anwendung ab, in der es verwendet werden soll. Prüfe, dass die Start- und die Endwörter vorhanden sind, dass die Lautstärke passt und sich die Datei wie erwartet verhält. Bestätige Format und alle Anforderungen zur Auslieferung im jeweiligen Tool – statt dich auf eine Vorschau als endgültiges Asset zu verlassen.
Prüfe außerdem die Nutzungsrechte des Plans. Wende die aktuellen Bedingungen für deinen gewählten Dienst an; das Erzeugen einer Probe stellt nicht automatisch Veröffentlichungsrechte her.
Halte das genehmigte Skript, die Aussprachehinweise, die Einstellungen und das ausgewählte Audio zusammen. Ein zuverlässiger Voice-Workflow beginnt mit Wörtern, denen ein Zuhörer folgen kann, und endet mit einer gespeicherten Aufnahme, die du tatsächlich geprüft hast.